🤖 ИИ не справился с созданием еды для приложения доставки Just Eat протестировала в Британии ИИ-сер

🤖 ИИ не справился с созданием еды для приложения доставки

Just Eat протестировала в Британии ИИ-сервис для оформления меню ресторанов. Если владелец не загрузил фото блюда, картинку для меню по названию блюда рисует нейросеть. Чтобы не обманывать покупателей, изображения помечают как сгенерированные.

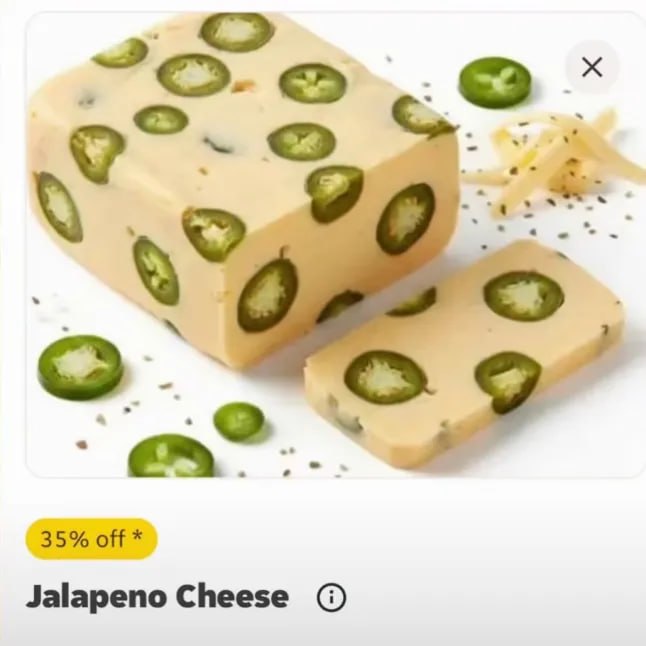
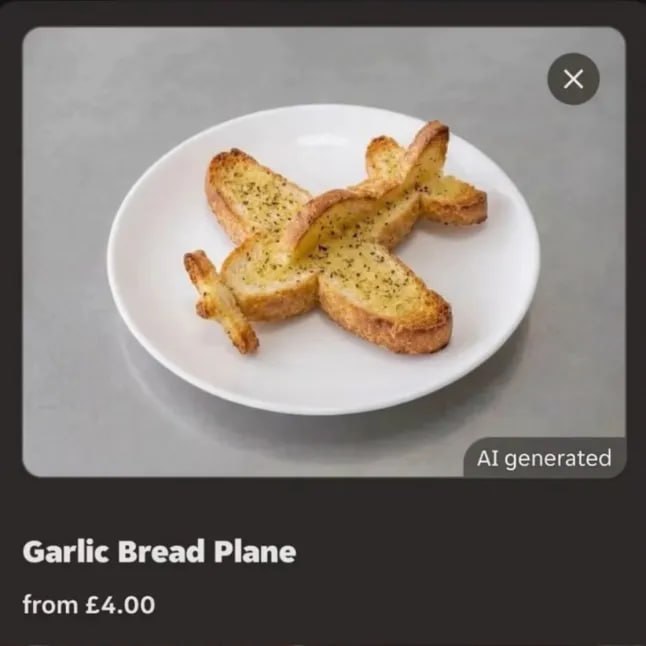
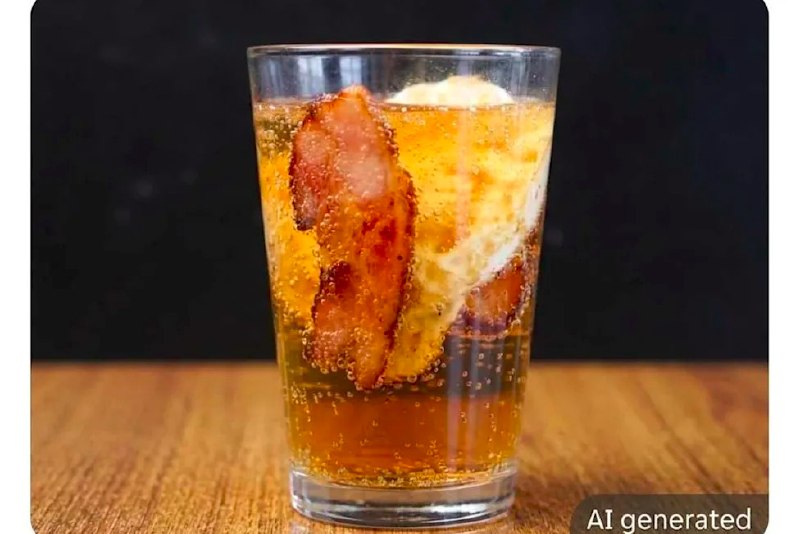
Первые тесты не везде прошли удачно: пользователи в сети публикуют странные изображения, появившиеся в Just Eat.

👨‍💻 Меньше всего повезло кафе в Северной Ирландии, где традиционно подают завтраки на содовом хлебе. ИИ не распознал контекст слова «soda» и превратил сэндвичи в странные «коктейли», в которых сосиски, бекон и яичница плавают в стакане с газировкой.

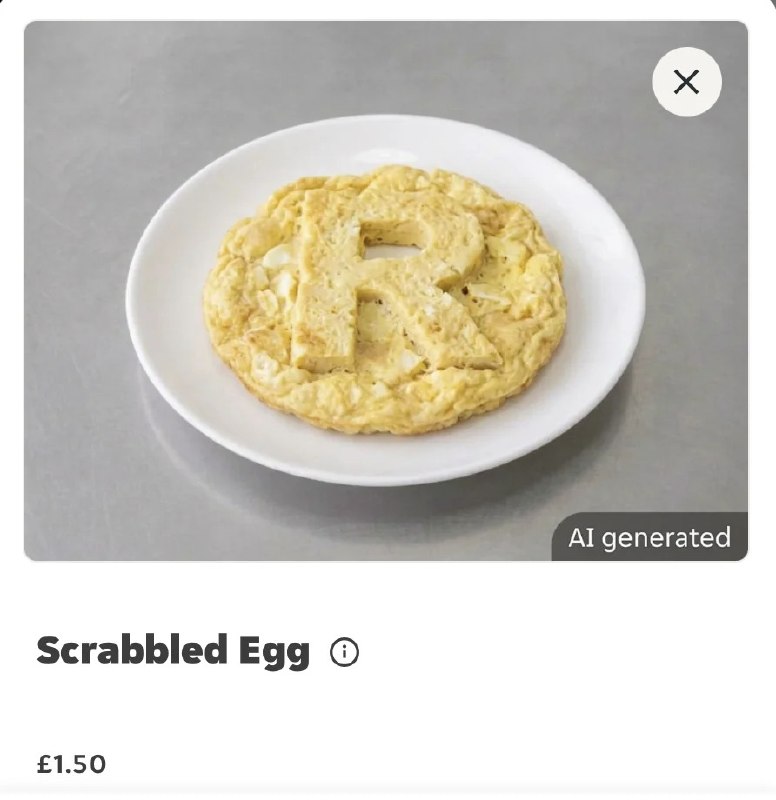
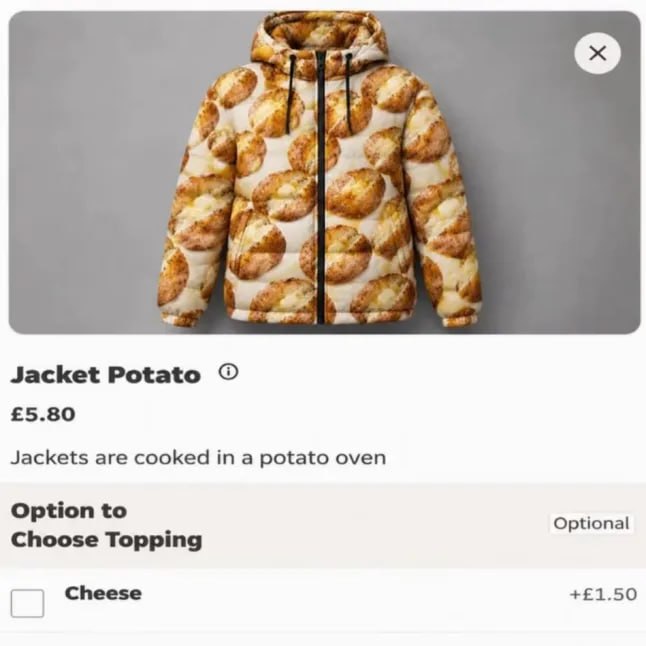
В меню других ресторанов нашли картошку фри, торчащую из маффинов, кубики сырой ветчины в холодной лепешке и даже куртку с принтом в виде картофелин вместо запеченной картошки. Часть ошибок появилась из-за опечаток в названиях. Например, scrabbled eggs (вместо scrambled — яичница-болтунья) превратилось в яйца с буквой, как на фишке из «Эрудита».

✅ Just Eat извинилась за ошибки и приостановила тест, пока не доработает систему. Неудачные изображения постепенно удаляют. В компании добавили, что странных фото было мало, а многие примеры, разошедшиеся по соцсетям, их сервис не создавал.

Как вы относитесь к меню с ИИ-фото?

❤️ — окей, лучше, чем ничего
👎 — это ужас и неуважение!

👋 Подпишитесь на Hi, AI!
🤖 ИИ не справился с созданием еды для приложения доставки
Just Eat протестировала в Британии ИИ-сер
🤖 ИИ не справился с созданием еды для приложения доставки
Just Eat протестировала в Британии ИИ-сер
🤖 ИИ не справился с созданием еды для приложения доставки
Just Eat протестировала в Британии ИИ-сер
🤖 ИИ не справился с созданием еды для приложения доставки
Just Eat протестировала в Британии ИИ-сер
🤖 ИИ не справился с созданием еды для приложения доставки
Just Eat протестировала в Британии ИИ-сер

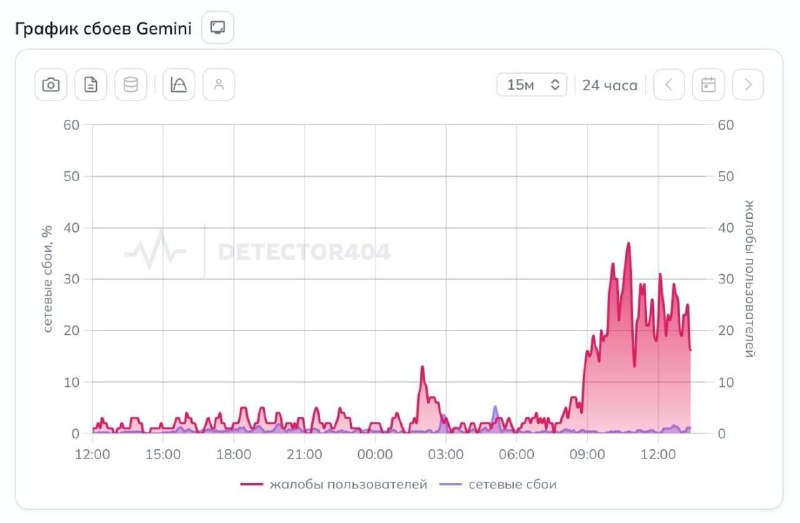
Google блочит доступ россиян к Gemini — с утра уже поступают жалобы на невозможность юзать ИИ Серв

Google блочит доступ россиян к Gemini — с утра уже поступают жалобы на невозможность юзать ИИ

Сервис отказывается работать даже с включённым VPN — другие способы обхода тоже не спасают.

Тем временем Gemini в Pointgpt.ai всё ещё доступен бесплатно 👀

Google блочит доступ россиян к Gemini — с утра уже поступают жалобы на невозможность юзать ИИ
Серв

🔍 Древний вирус отключил у шимпанзе ген развития мозга Несколько миллионов лет назад предки соврем

🔍 Древний вирус отключил у шимпанзе ген развития мозга

Несколько миллионов лет назад предки современных шимпанзе и бонобо заразились вирусом PTERV1, который закрепил копию своего генома в их ДНК. Эта вставка, передающаяся из поколения в поколение, отключила у наших «родственников-приматов» ген LINC00662, который участвует в росте и созревании нервных клеток в мозге.

Когда ученые из Лундского университета вырезали вирусный фрагмент из стволовых клеток шимпанзе, заглушенный участок снова заработал. А когда участок, наоборот, заглушили в человеческом мозговом органоиде, нейроны в таком «мини-мозге» созревали хуже и слабее наращивали отростки.

При этом почему человек избежал заражения вирусом — неясно. Возможно, наших предков защитил уникальный противовирусный белок TRIM5α. По другой версии, во время древней эпидемии предки шимпанзе и человека оказались изолированы друг от друга.

«Если бы у людей была такая же вставка, она, вероятно, отключила бы LINC00662 и изменила бы развитие клеток мозга», — говорит ведущий автор исследования Патрисия Гердес.

❗️ Однако это не значит, что своим развитым мозгом люди обязаны одному этому гену. Его отключение не обязательно радикально меняет развитие мозга, которое зависит от множества факторов.

👋 Подпишитесь на Hi, AI!
🔍 Древний вирус отключил у шимпанзе ген развития мозга
Несколько миллионов лет назад предки соврем

👨‍💻 ИИ опроверг одну из главных гипотез информатики, заявляет OpenAI Внутренняя модель компании наш

👨‍💻 ИИ опроверг одну из главных гипотез информатики, заявляет OpenAI

Внутренняя модель компании нашла алгоритм, существование которого противоречит гипотезе экспоненциального времени (ETH). Гипотеза, выдвинутая в 1999 году, описывала, насколько быстро можно решать целый класс сложных комбинаторных задач.

📌 В таких задачах легко проверить решение, но гораздо сложнее найти его. Например, в судоку убедиться, что числа расставлены верно, можно за минуту, а вот решить его так быстро вряд ли получится, особенно если размер поля увеличивается с 9x9 до 1000x1000. К этому классу также относятся задачи на составление расписания, задача коммивояжера и тысячи других.

Если перебирать варианты один за другим, то с каждой новой переменной максимальное время, необходимое для решения, удваивается. Существуют альтернативные чуть более быстрые способы, однако ETH утверждала, что время всегда увеличивается экспоненциально. Тем не менее при работе алгоритма от OpenAI время растет медленнее экспоненты.

🎓 Доказательство записали на языке Lean и выложили на GitHub. Теперь проверить заявление компании могут все желающие. Научную группу проверяющих возглавят профессор MIT Райан Уильямс и двое авторов ETH — Рассел Импальяццо и Рамамохан Патури.

Осторожность объяснима. В начале октября OpenAI опубликовала 722 статьи о нерешенных математических задачах. Меньше чем через сутки три работы пришлось отозвать из-за ошибки. Некоторые математики раскритиковали такой подход. Филдсовский лауреат Теренс Тао назвал «токсичными отходами» доказательства, которые ИИ-компании массово выпускают в гонке за бенчмарками.

✏️ На ETH опираются сотни работ в теории графов, вычислительной биологии и базах данных. Если доказательство подтвердится, то выводы о том, что какие-то задачи нельзя решить быстрее, потеряют основания.

Но сами быстрые алгоритмы для этих задач из опровержения ETH не вытекают — и искать их придется отдельно.

Должен ли ИИ заниматься математикой?

❤️ — да, разумеется!
👎 — нет, математика только для людей

👋 Подпишитесь на Hi, AI!
👨‍💻 ИИ опроверг одну из главных гипотез информатики, заявляет OpenAI
Внутренняя модель компании наш

🔊 Джек Дорси показал миру одну из самых реалистичных ИИ-моделей для генерации речи — диалоги с Dessa

🔊 Джек Дорси показал миру одну из самых реалистичных ИИ-моделей для генерации речи — диалоги с Dessa практически не отличить от общения с живым человеком.

Экспериментальную модель обучили на реальных диалогах без текстовых транскриптов. В отличие от многих конкурентов, она умеет перебивать собеседника, вмешиваться в разговор и мгновенно реагировать на сказанное — прямо как настоящий человек, который всегда готов вставить свои пять копеек.

Но есть нюанс: разработчики пока не спешат выпускать модель в открытый доступ. Слишком велик риск, что мошенники начнут использовать ее для телефонных афер.

💰 ИИ-пузырь уже лопнул в Китае Так считает Reuters. За последние четыре месяца индекс STAR50, котор

💰 ИИ-пузырь уже лопнул в Китае

Так считает Reuters. За последние четыре месяца индекс STAR50, который отслеживает 50 крупнейших компаний технологической площадки Шанхайской биржи (китайского аналога Nasdaq), рухнул на 40%.

На пике в конце июня индекс превысил 2,2 тыс. пунктов, а сейчас откатился до 1,3 тыс. пунктов, практически обнулив весь рост с начала года. Рынок потерял $480 млрд капитализации.

И даже несмотря на это, акции остаются переоцененными. Инвесторы платят за компании индекса в среднем в 100 раз больше их годовой прибыли, на пике было почти 250. Для сравнения, у технологического Nasdaq этот показатель (P/E) около 30.

🔄 Вышедшие на биржу в Гонконге «ИИ-тигры» Zhipu AI и MiniMax подешевели на 80-90% от пика, чипмейкеры Moore Threads и MetaX — примерно на 60%, производитель андроидов Unitree — на 39%. Большинство из них всё ещё стоит в 3-4 раза дороже цены IPO, потому что в первые дни торгов их акции взлетели в разы. MiniMax же откатилась к цене размещения.

Goldman Sachs отмечает, что ИИ-акции составляют около 42% рыночной капитализации китайских компаний. Падение рынка «зацепило» многих розничных инвесторов и обычных китайцев, хранящих сбережения в акциях.

❗️ При этом единого четкого повода для падения не было. На инвесторов понемногу давили завышенные цены, налоги и угроза запрета китайского оборудования в дата-центрах США.

«Исключений нет. Все пузыри неизбежно лопаются», — констатирует партнер Shanghai Zhuozhu Investment Management Ван Чжо.

ИИ-пузырь лопается?

❤️ — да, это было ожидаемо
🔥 — нет, все еще отскочет

👋 Подпишитесь на Hi, AI!
💰 ИИ-пузырь уже лопнул в Китае
Так считает Reuters. За последние четыре месяца индекс STAR50, котор

🤖 Исследователи нашли способ сократить стоимость генерации ответов ИИ на корпоративных объемах Круп

🤖 Исследователи нашли способ сократить стоимость генерации ответов ИИ на корпоративных объемах

Крупные компании из-за требований безопасности не могут отправлять данные во внешние облака и вынуждены крутить десятки разных нейросетей на своих серверах, сжигая дефицитные мощности GPU. Исследователи Т-Банка нашли решение этой проблемы и представили два новых метода обучения моделей на ведущей мировой конференции уровня A* EMNLP 2026 в Будапеште.

🔍 Первая разработка позволяет объединить рой узких нейросетей на одной универсальной модели. Команда впервые описала воспроизводимую методику постобучения русскоязычных LLM с агентскими навыками. Модель на базе Qwen3-32B сначала дообучили на корпоративных и открытых данных, затем улучшили с помощью обучения с подкреплением по трем направлениям — следование инструкциям, вызов функций и корпоративные задачи, после чего объединили в одну универсальную методом SLERP.

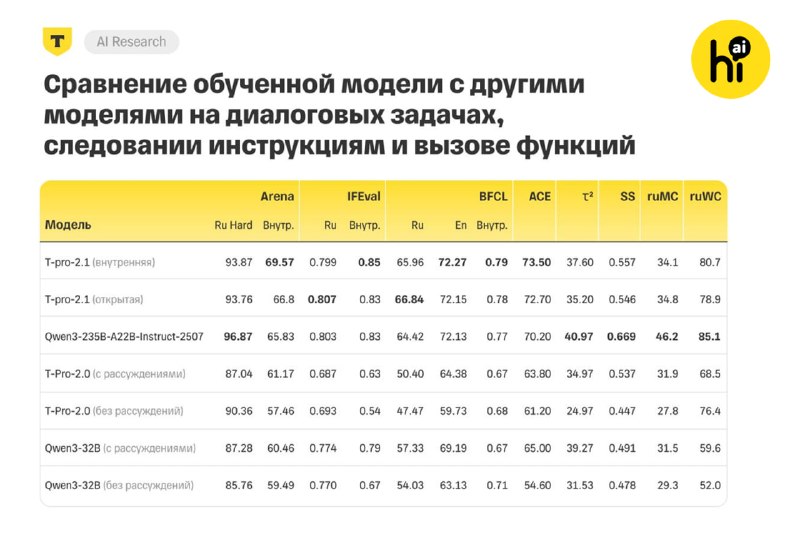
👍 Результат: одна модель на 32 млрд параметров взяла на себя запросы более 200 внутренних сервисов банка и половину трафика его LLM-платформы. Обработка запросов стала в 2,8-3,9 раза дешевле (в отдельных сервисах — до 9 раз) по сравнению с семикратно более тяжелой Qwen3-235B. При этом на корпоративных тестах компактная версия обошла гиганта: 69,6 балла против 65,8. По инструкциям — 0,85 против 0,83, вызов функций — 0,79 против 0,77.

✈️ Второй метод решает проблему дорогой оцифровки бумаг. С помощью пайплайна отбора сложных PDF-примеров исследователи обучили визуально-языковую модель на базе Qwen3.5-35B-A3B-Base извлекать любые реквизиты и суммы по текстовому запросу. При общих 35 млрд параметров она задействует только 3 млрд на один запрос, для запуска понадобится один Nvidia H100.

💰 Разбор документов через такую модель обходится на 80% дешевле полностью ручной обработки и на 50% дешевле лучших открытых аналогов.

✅ Исследователи опубликовали методику создания внутренних тестов, описание пайплайна постобучения и саму языковую модель с открытыми весами (обученную на публичных данных).

👋 Подпишитесь на Hi, AI!
🤖 Исследователи нашли способ сократить стоимость генерации ответов ИИ на корпоративных объемах
Круп

📌 Алгоритм знает, где вы будете 7-го ноября RecSys-митап в Москве для тех, кто уже строит рекоменда

📌 Алгоритм знает, где вы будете 7-го ноября

RecSys-митап в Москве для тех, кто уже строит рекомендательные системы и хочет делать это еще лучше.

В программе — доклады от топовых экспертов Сбера с разбором кейсов, свежих подходов и неочевидных решений.

После официальной части — нетворкинг. Время в узком кругу профессионалов и сообщества Зеленый RecSys.

Участие бесплатное, но количество мест ограничено.

Москва. Суббота. 7 ноября. RecSys!

➡️️ Регистрируйтесь

📌 Алгоритм знает, где вы будете 7-го ноября
RecSys-митап в Москве для тех, кто уже строит рекоменда
Еще посты

Свежие комментарии